简介
LLM推理的自回归机制导致了其推理效率低下的问题,这种机制需要频繁的从HBM中加载参数/上下文进行计算。推测解码(Speculative Decoding,SD)针对自回归特性进行了加速优化,其通过一个更小更快的草稿模型(Draft Model,DM)进行推测,将推测的结果交给目标模型(Target Model,TM)进行并行验证。这种并行机制能极大提高并行计算单元的利用率,提高模型推理速度。
推测解码相关工作划分
- 草稿生成的优化。
- 草稿验证流程的优化。
- 系统层面的优化, 包括在流水线、硬件和分布式协同上改进。
接下来我们从学术和项目两个方向解读各个工作。
拒绝采样 有建议分布$q(x)$和目标分布$p(x)$,对于$u \sim U(0,1)$,$u<\frac{p(x)}{M \cdot q(x)}$为接受样本的标准,那么获得的样本和直接从$p(x)$采样概率相同
学术研究
SpecInfer
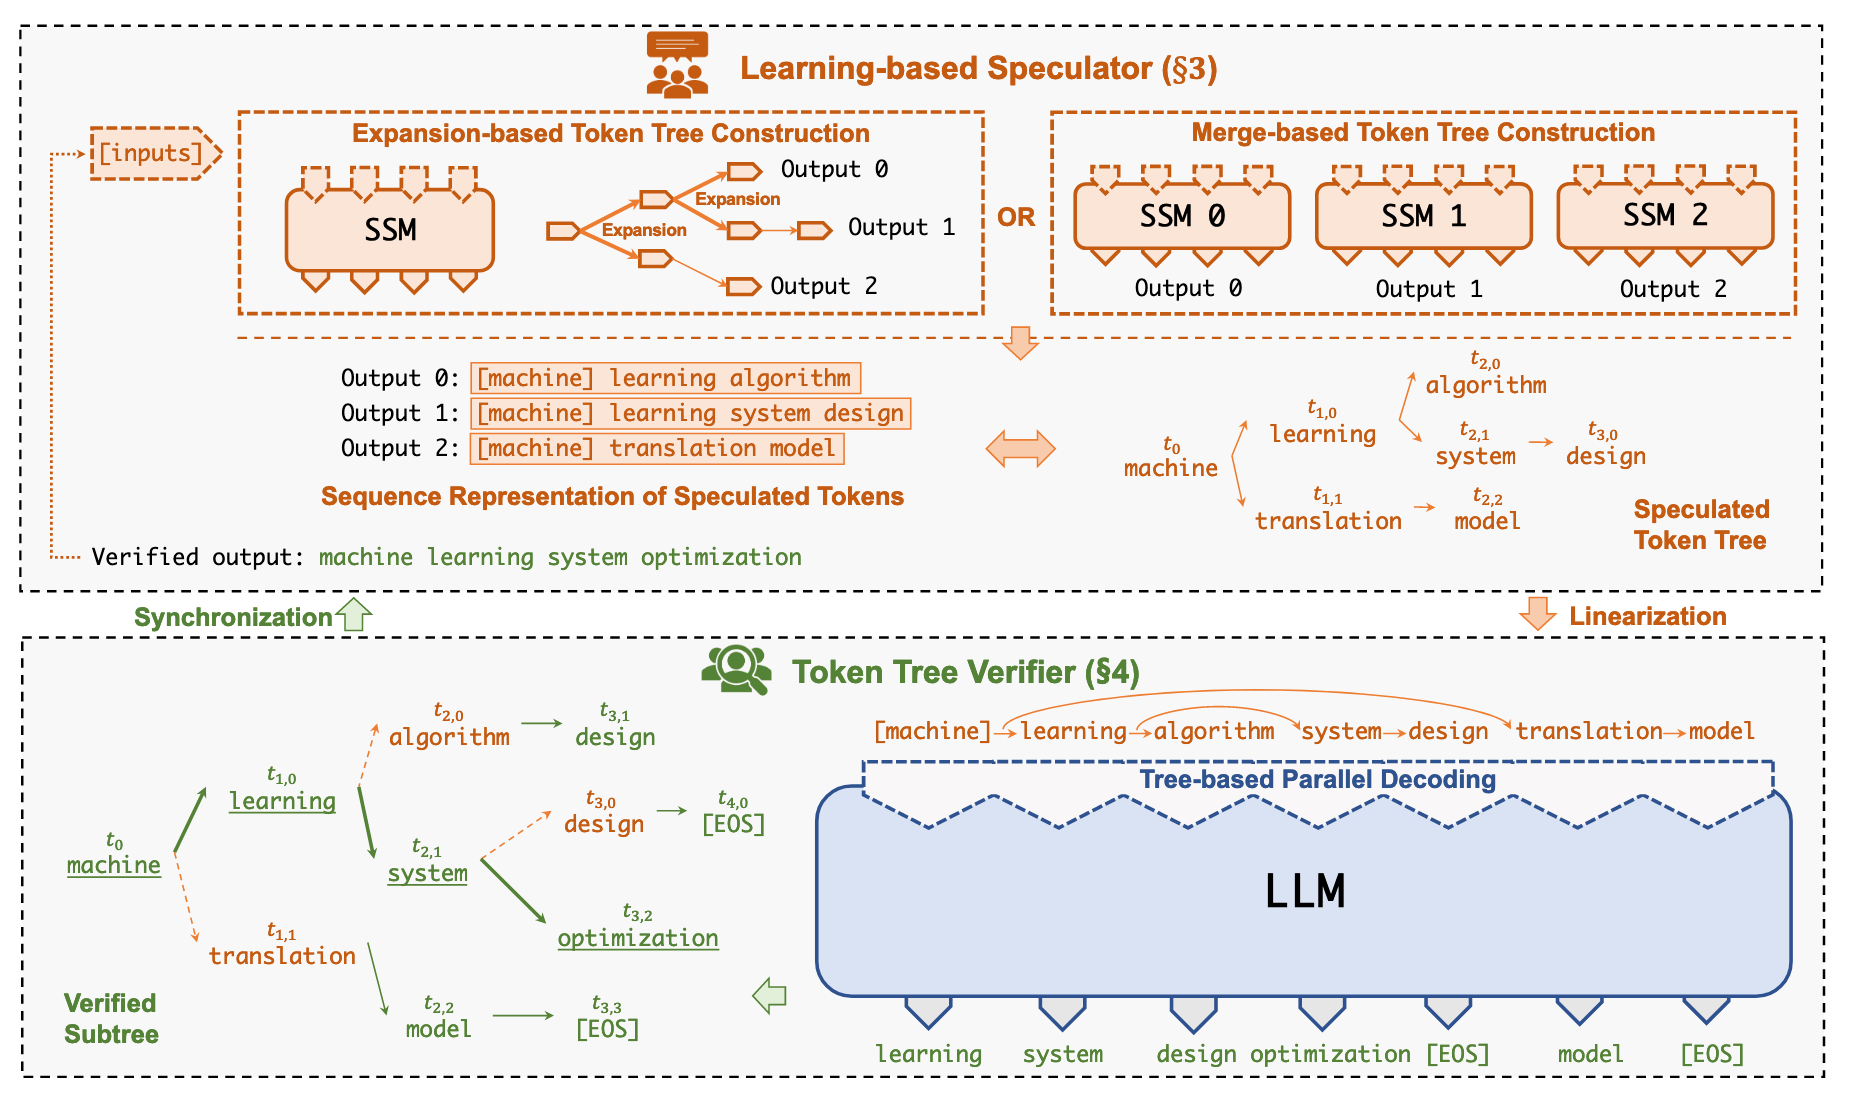
SpecInfer [3] 提出了基于树的推测推理,通过提高单次验证吞吐有效降低了内存访问和端到端延迟。其设计实现了Learning-based Speculator和Token Tree Verifier两个组件来完成Token Tree的生成和验证。
Learning-based Speculator
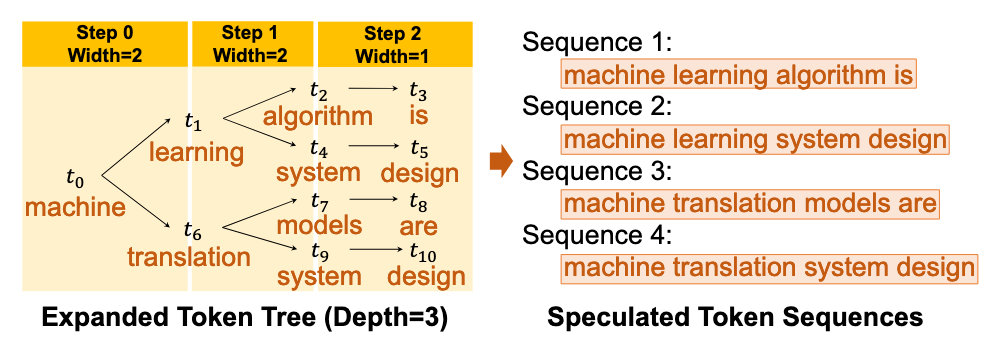
SpecInfer提供了Expansion-based和Merge-based两种token tree生成方式。前者使用单一SSM,通过top-k类似采样,每一step不止选择一个token从而生成树型结构,如图SpecInfer给出了一种简单的width-limit方法,限制树每一层的宽度进行采样;后者在模型训练阶段,每次只训练一个SSM,并将样本中与SSM输出不同的样本去除继续训练,这样SSM会覆盖更多的LLM输出。
Token Tree Verifier
对于token树$\mathcal{N}$和任意的节点$\mathcal{u} \in \mathcal{N}$,有:
$$ \text{TreeAttention}(\mathcal{u}) = \text{Attention}(S_u) \quad \forall\mathcal{u} \in \mathcal{N} $$
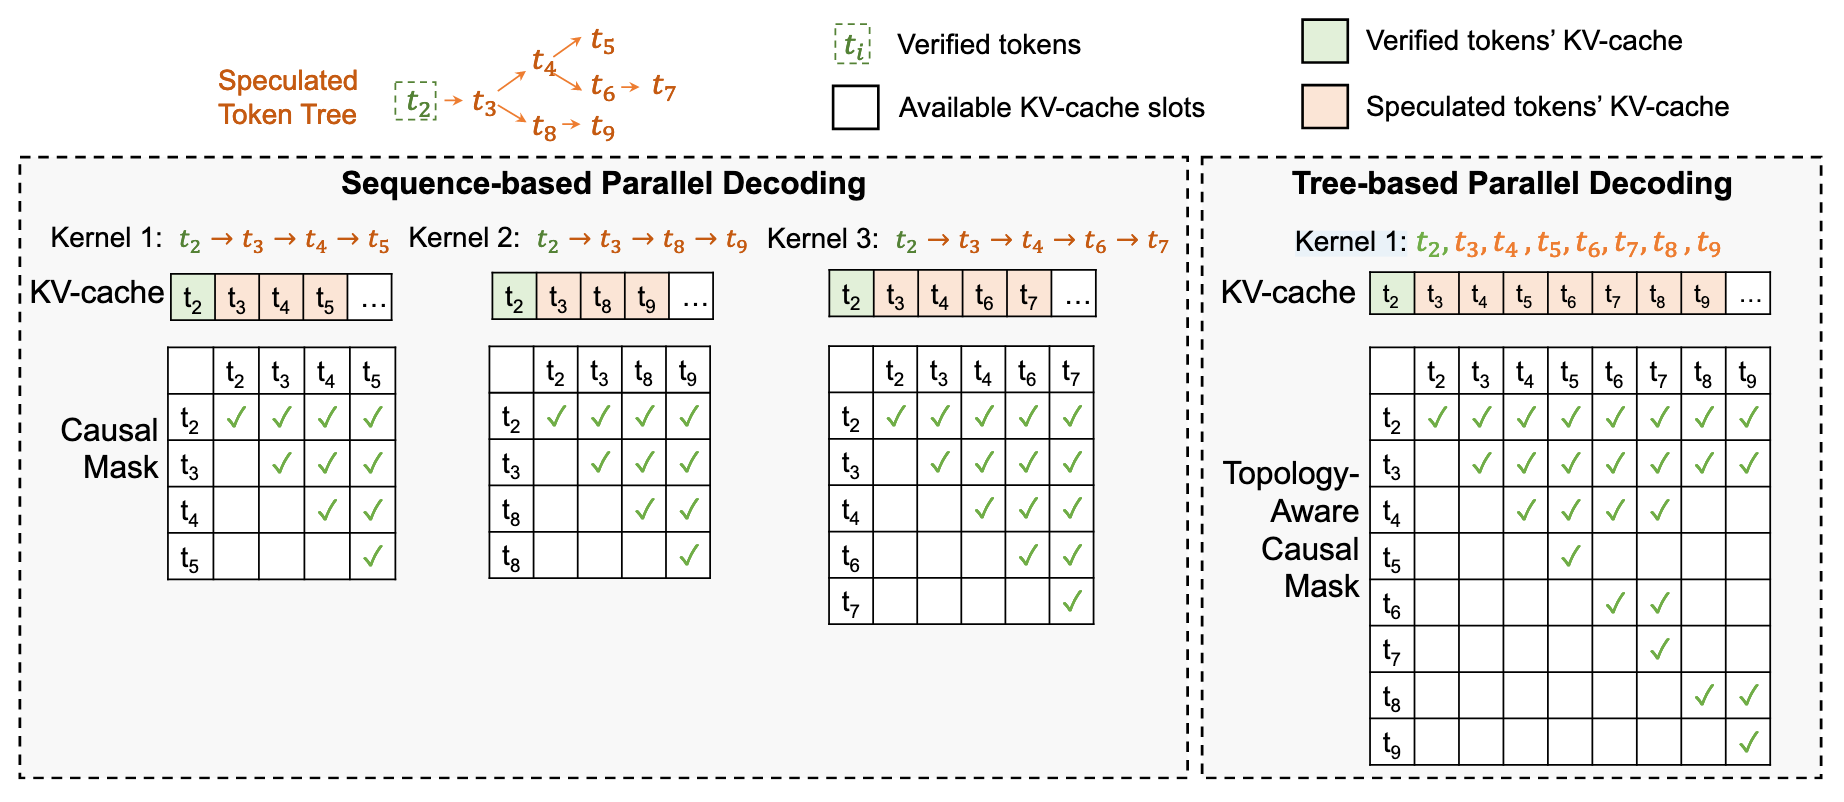
为了解决如图左所示的内核切换和相同前缀冗余计算问题,SpecInfer通过对Tree深度顺序遍历并创建对应的Topology-aware causal mask,在一个内核中通过mask进行所有序列的并行计算。
SpecInfer提出了Greedy解码和随机解码两种验证方案,其中随机解码采用了如图的多步推测采样方案,并且证明了Multi-step推测采样和直接从LLM采样分布相同,并且其采样通过率更高。
其做法为根据拒绝采样算法分别对每个小的SSM计算其是否接受采样,如果每个SSM都不接受则失败,这样采样的分布和从target模型采集相同。
SpecExec
消费级设备在推理大模型(RTX3090 for llama-70B)时只能将模型参数卸载到memory/SSD,SpecExec [4] 目标是提高推测解码有效性,以在RAM卸载的消费者硬件运行LLM。
SpecExec分析发现,(i)在消费者设备执行数千token的处理和执行单个token几乎一致,这是因为时间被模型加载时间所掩盖了;并且(ii)在草稿长度不断增长时,接收的token存在一个上界,即便这是一个7B的草稿模型(能采用这种模型的原因是验证时的参数加载时间给足了生成时间)。
同时,模型输出token时,有少数几个token概率和接近100%,SpecExec考虑采用Beam Search可以覆盖大多token序列,但是需要考虑到这种确定性算法和随机采样的不适配性。因为选择draft模型的任意特性,其直接在target model进行直接采样验证,这导致了接受率的降低。
SpecExec会在draft树创建后,直接并行计算每个节点对应的tree节点的target分布概率并保存在缓存中,key为前缀,value为概率分布。然后其会从cache中采样下一个token,如果缓存中不存在对应前缀的key,则重复之前的draft树创建生成新的缓存。
EdgeLLM
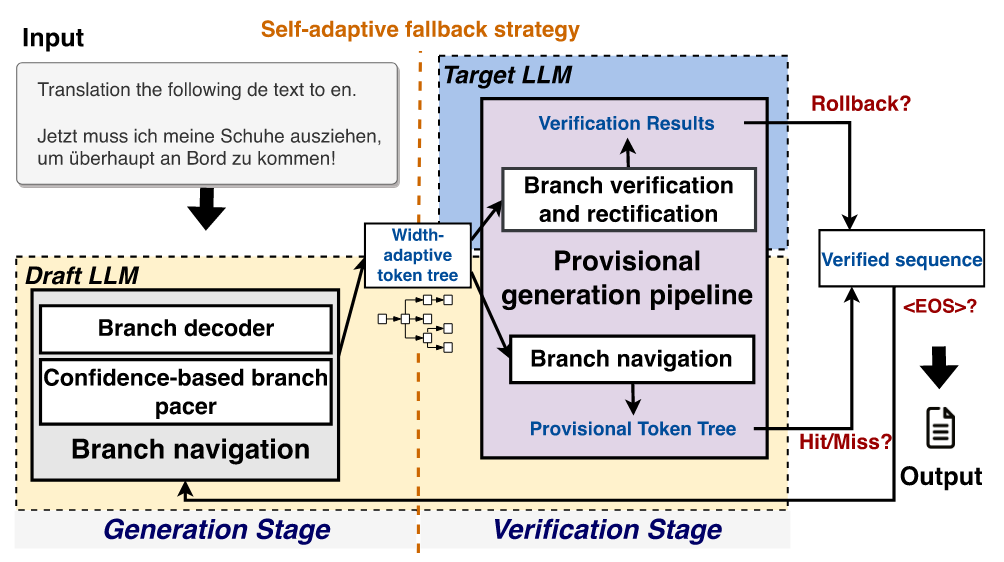
EdgeLLM [5] 面向边缘集群,旨在提高IoT和Phone等边缘设备上模型推理速度,提高设备推理能力。在Jetson等IoT设备和Phone上,推理速度分别提升2.9–9.3倍和3.5–4.7倍。如在Phone上,其推理10B以上模型能力达到1 tokens/s。
如架构图所示,在生成阶段(Generation Stage),Draft LLM生成草稿树并将其交给Target LLM;在验证阶段,Target模型进行草稿验证,同时Draft模型并行进行草稿生成。
Compute-Efficient Branch Navigation and Verification
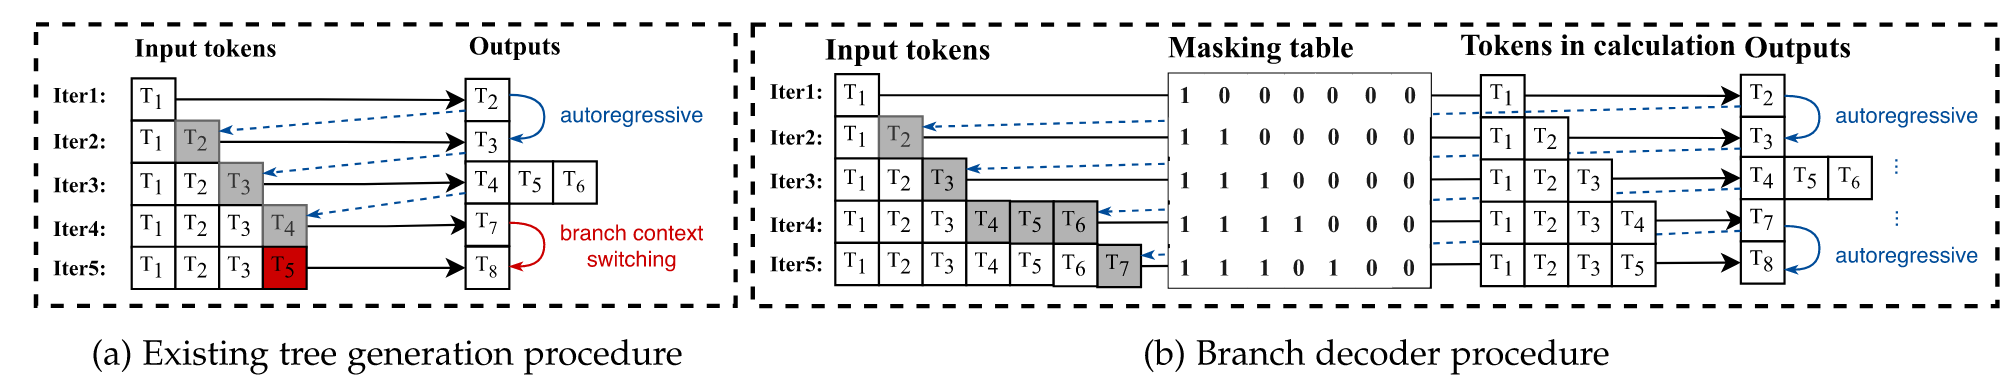
在算力充足的云场景,batch可以显著提高生成吞吐。EdgeLLM发现,在算力受限的边缘设备上进行batch,当batch增加时,延迟成线性增加。更详细的,有两个问题:
- 在不用batch加速的情况下,需要选择分支进行计算,选择哪个分支呢?
- 生成不同分支的token需要进行切换,如何让这种切换更高效?
EdgeLLM提出了两种方法:
- Confidence-based branch pacer:其定义了树的质量为D,每次生成token目标为降低质量D,以提高整个树的置信度。
- Branch decoder:在生成过程加入mask,使得每次加载全部token数据和一个mask,不需要每次切换branch增加开销
Self-Adaptive Fallback Strategy
边缘场景验证开销大,为了保证验证高效,EdgeLLM采用了一种自适应的fallback机制,在Token Tree的置信度($T_c$)达到阈值($\alpha$)时,才进行回退验证。其中阈值$\alpha$的值是根据实际情况变化的:
$$ \alpha_{i+1} = \begin{cases} \alpha_{i} * 0.5 & \text{if } N_{correct}=N_{all} \\ {\alpha_{i}/T_c}^{\frac{N_{all}-N_{correct}}{N_{all}}} & \text{if } N_{correct}\lt N_{all} \end{cases} $$Provisional Generation Pipeline
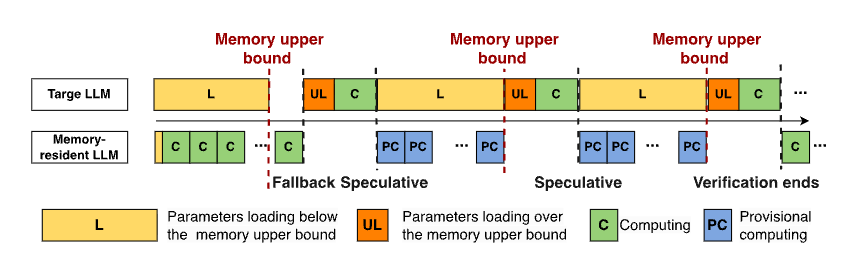
为了解决模型(13B)在内存受限场景(Xiaomi10)下计算利用率低的问题,EdgeLLM提出了Provsisional Generation,在目标模型验证过程中进行草稿生成。其中为了防止草稿模型和目标模型的互相干扰,做了如下机制:1)目标模型和草稿模型不同时进行计算。2)目标模型参数加载到memory bound(L),只在进行验证时加载剩余参数(UL),如果加载完参数仍为触及到bound,草稿模型可同时进行临时计算(PC)。
PipeInfer
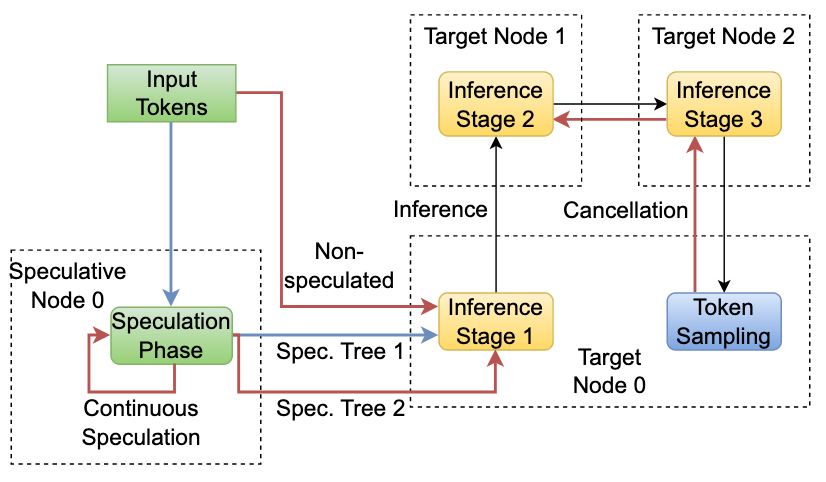
PipeInfer [6] 目标是提升token间延迟并提高单请求场景系统利用率;同时提升对低推测接受率和低带宽的容忍度。 其工作其实是在猜测的同时进行target模型的推理,这样在低推测接受率或者带宽场景下的最低保障。PipeInfer为了实现这种同步设计了一套流水线方案,保证DLM推测和TLM推理的同步。
PipInfer采用了几种技术:- Asynchronous Speculation: DLM推测时,TLM同步进行推理。
- Continuous Speculation:减少推测批次的大小,使其能和推理阶段形成流水线。
- Pipelined KV Cache Multibuffering:流水线过程中KV cache的管理。
- Early Inference Cancellation:这像是一种流水线硬同步机制,当推测阶段推测token已经落后或错误时,强制退出当前推理。
Medusa
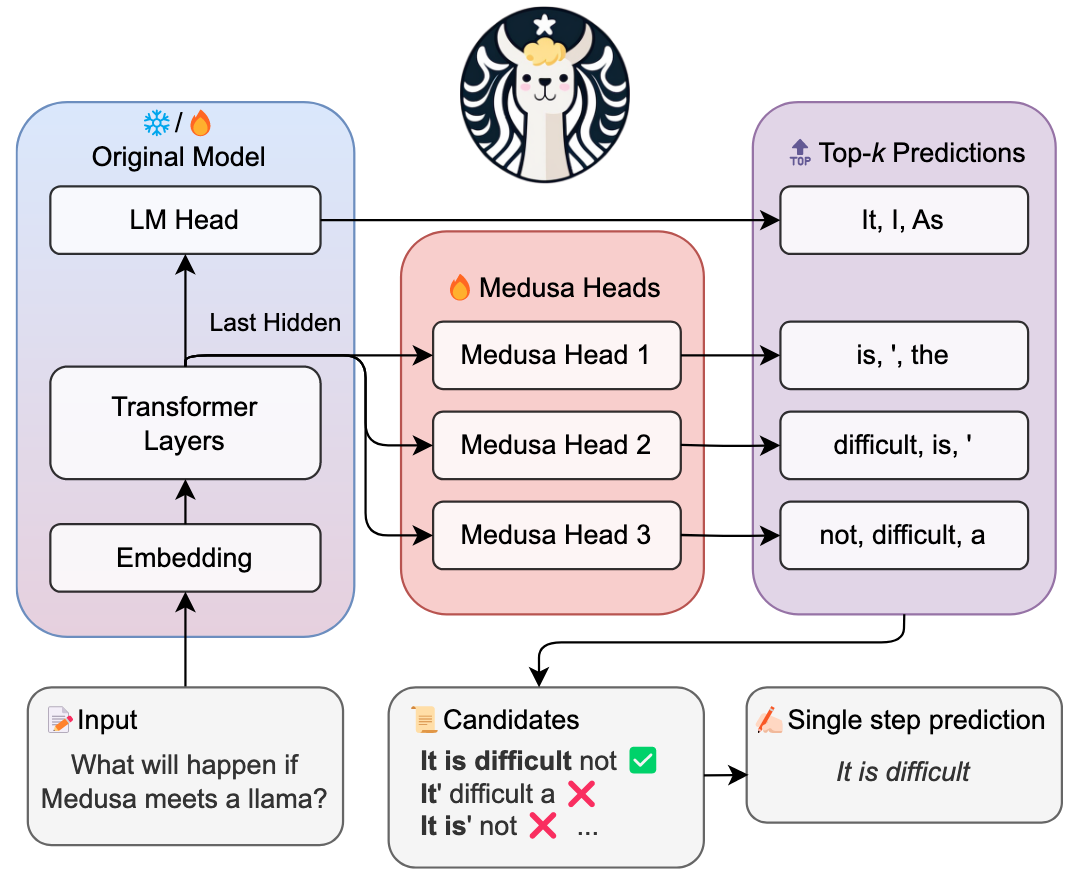
Medusa [7] 通过添加额外的解码头来并行预测后续token以加快推理。 Medusa Head$_k$都接收Last Head作为输入,输出第k个位置的top-k token。这可以通过冻结主干LM进行Head微调,实现无损加速(MEDUSA-1);Head也可以和主干LM一起进行微调,以获取更高的预测准确率和更高的加速(MEDUSA-2)
EAGLE
To be completed
SpecTr
To be completed
References
[1] Unlocking Efficiency in Large Language Model Inference: A Comprehensive Survey of Speculative Decoding (Xia et al., Findings 2024)
[2] Speculative Decoding and Beyond: An In-Depth Survey of Techniques (Hu et al., arXiv 2025)
[3] SpecInfer: Accelerating Large Language Model Serving with Tree-based Speculative Inference and Verification (Miao et al., ASPLOS 2024)
[4] SpecExec: Massively Parallel Speculative Decoding for Interactive LLM Inference on Consumer Devices (Svirschevski et al., NeurIPS 2024)
[5] EdgeLLM: Fast On-Device LLM Inference With Speculative Decoding (Xu et al., TMC 2025)
[6] PipeInfer: Accelerating LLM Inference using Asynchronous Pipelined Speculation (Butler et al., SC 2024)
[7] MEDUSA: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads (Cai et al., ICML 2024)